
La skill Claude pour écrire comme un humain : ce que l'étude StoryScope a mesuré, les sept contrôles et notre vrai test
61 608 histoires, 304 traits narratifs, et une IA reconnue à 93,2 % sans regarder un mot de style. Ce guide reprend les chiffres de l'étude StoryScope avec leur page, en tire sept contrôles illustrés chacun d'un exemple, donne la skill /humain complète et la façon de l'installer dans Claude Code et dans l'appli Claude, puis notre vrai test : 6 traits sur 12 vont vers l'humain, 3 vers l'IA, 3 ne bougent pas. Papier, données publiques et pages d'aide relus le 11 novembre 2026.
Eigenflow · mis à jour le
Le fichier à copier, le zip pour l'appli Claude, les chiffres de l'étude avec leur page, et ce qu'a donné notre test, y compris les trois traits partis du mauvais côté.
Télécharger le PDF ↓L'essentiel en 30 secondes
- Sur des nouvelles d’environ 5 000 mots, la structure seule repère l’IA avec un score de 93,2 % (macro-F1), sans tenir compte d’un seul mot de style.
- Les mots trahissent l’IA encore mieux : un détecteur qui lit le texte brut monte à 99,9 % sur les mêmes histoires. L’intérêt de la structure, c’est qu’elle reste quand on a nettoyé les mots.
- Une réécriture automatique qui chasse clichés et prose ampoulée fait passer leur détecteur de 95,5 % à 93,9 %. À peine un point et demi.
- Dans Claude Code, la skill se range dans ~/.claude/skills/humain/SKILL.md et s’appelle avec /humain. Dans l’appli Claude, on envoie le zip dans Personnaliser, Compétences. Ça marche avec toutes les offres, la gratuite comprise.
- Notre test, un seul essai noté par Claude : sur 12 traits mesurés, 6 vont vers l’humain avec la skill, 3 vers l’IA, 3 ne bougent pas.
- La skill ne rend pas un texte indétectable. Et l’étude porte sur des fictions en anglais : l’appliquer à un post ou à un mail en français reste une extrapolation.
Partie 1Ce que l’étude a trouvé
Qui l’a faite, et sur quoi
StoryScope est signée Jenna Russell, Rishanth Rajendhran, Chau Minh Pham et Mohit Iyyer, de l’université du Maryland, et John Wieting, de Google DeepMind. Le papier est sur arXiv (numéro 2604.03136) et a été accepté à la conférence COLM 2026.
Les chercheurs sont partis de 10 272 nouvelles publiées, écrites par des humains. Pour chacune, un modèle a deviné la consigne de départ, du genre « écris une histoire sur un métallurgiste dont le nouveau chien semble télépathe ». Cette consigne a ensuite été donnée à cinq modèles : Claude Sonnet 4.6, GPT-5.4, Gemini 3 Flash, DeepSeek V3.2 et Kimi K2.5. Au total, 61 608 histoires de 4 753 mots en moyenne.
Chaque histoire a été décrite par 304 traits narratifs. Deux questions du lot : le narrateur explique-t-il la morale ? Comment le héros entre-t-il en scène ? C’est Gemini 3 Flash qui a répondu, histoire par histoire, et des humains ont vérifié ses réponses sur 240 cas (accord de 0,84 sur une échelle qui va jusqu’à 1).
93,2 %, sans regarder le style
Ils ont entraîné un classifieur sur ces traits en retirant tout ce qui relève du style : le rythme des phrases, la densité d’images. Il dit si une histoire vient d’un humain ou d’une IA avec un macro-F1 de 93,2 % (page 6, tableau 2). Le macro-F1 fait la moyenne des scores obtenus sur les deux camps. Prends-le comme un ordre de grandeur de réussite.
Ce chiffre a une limite qu’il faut connaître. Sur les mêmes histoires, un détecteur entraîné sur le texte brut (ModernBERT) atteint 99,9 %, et le modèle qui combine structure et style 96,0 %. Les mots restent donc le signal le plus fort. La structure compte pour une autre raison : on la corrige beaucoup moins facilement, et elle tient quand le style a été nettoyé.
La forme de l’écriture
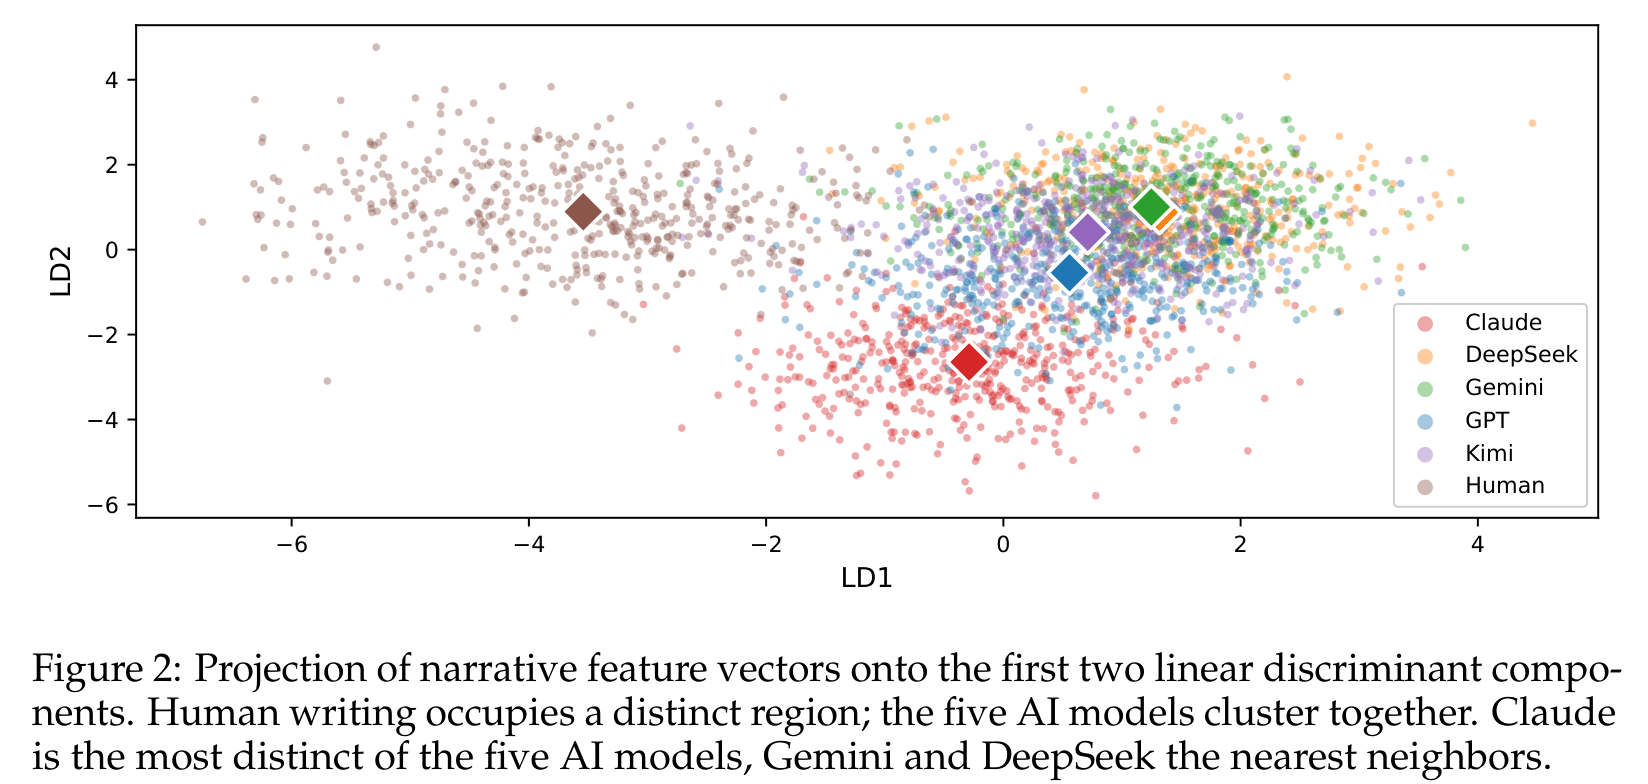
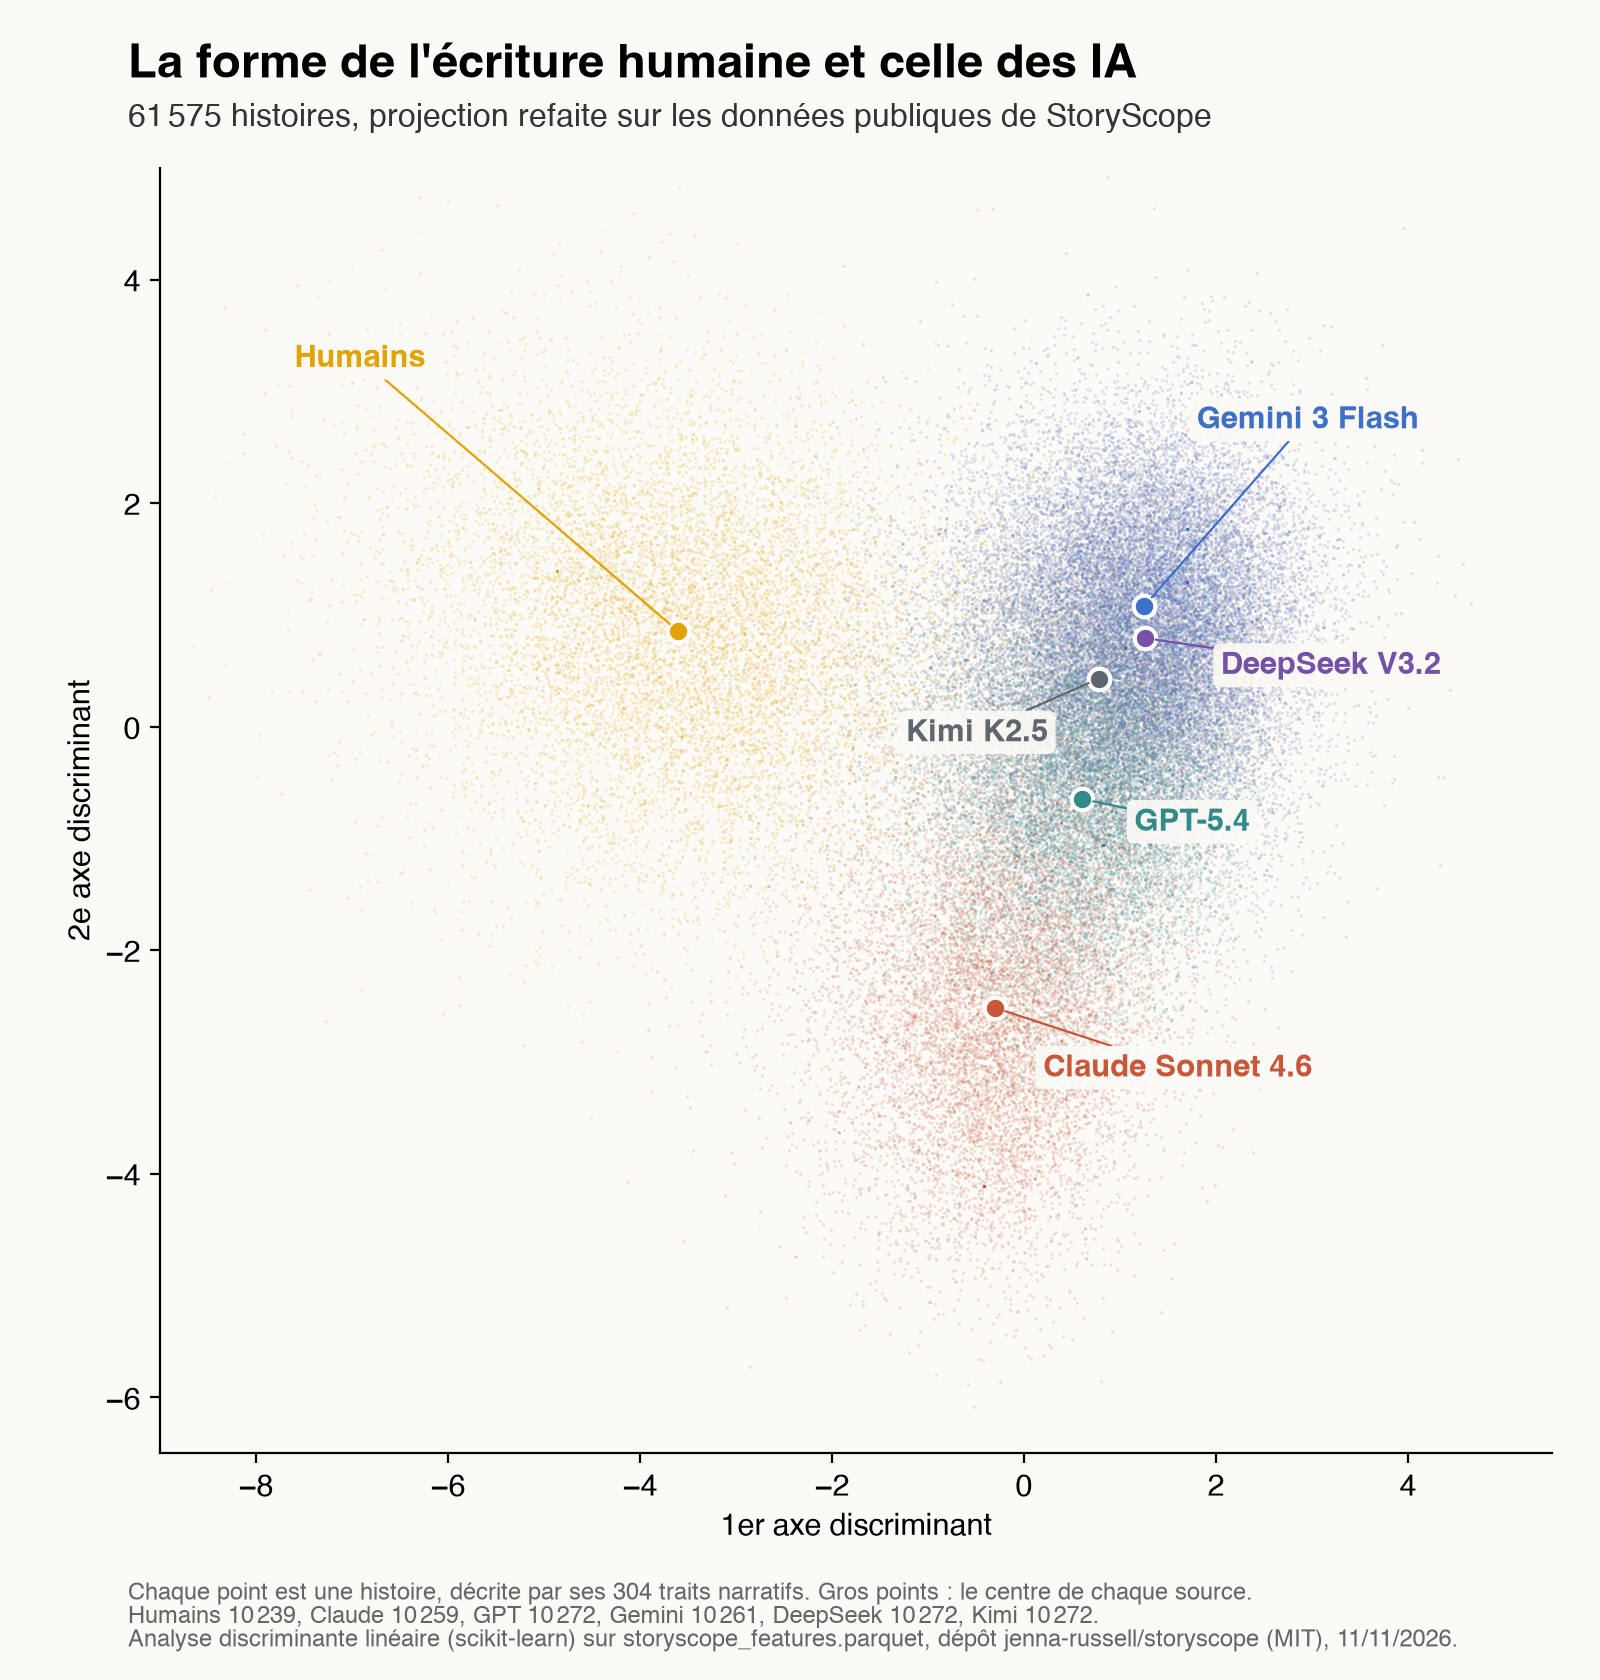
Les cinq modèles écrivent dans la même zone. Les humains occupent une autre région, plus étalée : une histoire humaine est en moyenne 22 % plus loin du centre de son groupe qu’une histoire d’IA du sien (page 9). Elles sont aussi plus rares. 24,7 % des histoires humaines tombent dans les 10 % d’histoires les plus singulières du corpus, contre 7,1 % des histoires d’IA.
Les données de l’étude sont publiques, sous licence MIT. On a refait la figure avec : 61 575 histoires (le fichier public en compte un peu moins que le papier), les 304 traits (le papier n’a gardé que les traits narratifs), la même méthode. La forme est la même. Claude se détache vers le bas ; Gemini, DeepSeek et Kimi se superposent presque.
Nettoyer le style ne suffit pas
Les chercheurs ont pris 278 histoires de Gemini et les ont fait réécrire par Gemini lui-même avec LAMP. Cette méthode repère les clichés, la prose ampoulée et les explications en trop, et les corrige en s’inspirant de 25 exemples de corrections faites par des écrivains professionnels. Leur détecteur de structure reconnaissait les originaux à 95,5 %. Après réécriture, 93,9 % (page 8).
Retirer les tirets longs ou les mots à la mode, c’est travailler sur la même surface. Le papier ne l’a pas testé, mais ça ne change rien à la façon dont l’histoire est construite. Seule réserve : ce test porte sur leur détecteur, celui qui ne lit que la structure. Face à un détecteur qui lit le style, nettoyer les mots peut changer le score. Le papier cite d’ailleurs une autre étude où un modèle entraîné à imiter le style humain fait tomber la détection de 97 % à 3 % (page 2).
Partie 2Les sept contrôles
Les chiffres viennent du tableau 16 du papier (page 26) : la part des histoires humaines face à la moyenne des cinq modèles. Pour chaque contrôle, un exemple écrit pour ce guide, avant et après.
Contrôle 1 : la morale dite
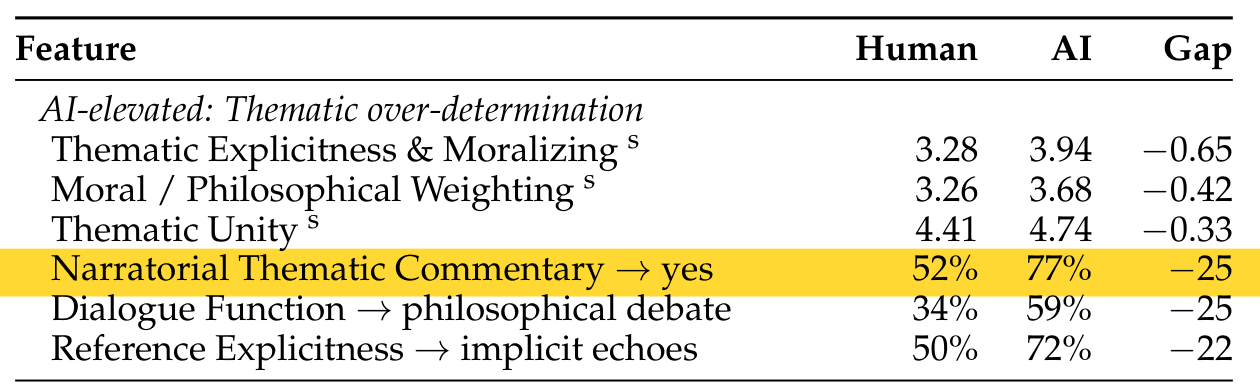
Le narrateur explique le sens de l’histoire dans 77 % des textes d’IA, contre 52 % chez les humains. Le papier résume : l’IA « explique le sens au lieu de faire confiance au lecteur pour le deviner » (page 7). Ses dialogues tournent aussi plus souvent au débat d’idées (59 % contre 34 %).
Dis l’idée une fois, là où elle frappe le plus, ou laisse le lecteur la trouver. Jamais de dernière phrase qui tire la leçon.
- Avant : « J’ai attendu trois mois. Finalement, il a payé. Cette histoire m’a appris une chose essentielle : la patience est la clé de toute relation commerciale. »
- Après : « J’ai attendu trois mois. Il a payé un mardi, sans un mot, 2 340 € pile. Son devis est toujours punaisé au-dessus de mon bureau. »
Contrôle 2 : l’émotion jouée par le corps
Gorge serrée, cœur qui cogne. Chez l’IA, c’est la façon principale de montrer une émotion dans 81 % des histoires, contre 38 % chez les humains. Les humains, eux, nomment l’émotion : 29 % contre 8 %.
Écris « j’avais peur ». Garde le détail physique pour un seul moment, s’il le mérite.
- Avant : « Sa gorge se serra. Son cœur cognait dans sa poitrine quand elle ouvrit le mail. »
- Après : « Elle a ouvert le mail. Elle avait peur, et ça l’agaçait d’avoir peur d’un mail. »
Contrôle 3 : l’histoire trop droite
Pas de piste secondaire dans 79 % des textes d’IA (57 % chez les humains). Une fin réglée par une décision du héros dans 69 % des cas (46 %), ou par une prise de conscience dans 47 % (27 %). Les humains sautent plus dans le temps, avec des retours en arrière et des fins moins rangées.
Ajoute une digression qui ne sert pas ta thèse, ou laisse une question ouverte. Et finis juste après le moment fort, sans épilogue. Dans les données publiques, c’est le cas de 69,5 % des histoires humaines contre 51,2 % des histoires d’IA, et l’après-coup est bref ou absent dans 85 % des histoires humaines contre 49 %.
- Avant : « Le lendemain, il signa le contrat. Des années plus tard, il repensait souvent à ce jour et comprenait que c’était là que tout avait commencé. »
- Après : « Il a signé le lendemain, au stylo du client, parce que le sien ne marchait plus. »
Contrôle 4 : les allusions vagues
« Un livre célèbre », « une vieille légende ». 72 % des textes d’IA s’en tiennent à des échos vagues (50 % chez les humains), et ils nomment deux fois moins souvent une œuvre précise (24 % contre 47 %). D’après le papier, l’IA évite en général de nommer de vraies marques, de vrais lieux, de vraies œuvres (page 7).
Mets le titre, le nom, la ville, la marque.
- Avant : « J’ai lu un livre célèbre sur l’organisation, et ça a tout changé. »
- Après : « J’ai lu « Getting Things Done » de David Allen dans le TER entre Lyon et Grenoble. J’en ai gardé une règle, celle des deux minutes. »
Contrôle 5 : le décor qui pense à la place du personnage
La pluie quand il est triste, la lumière qui baisse quand elle a peur. Les IA font plus jouer au décor le reflet de l’humeur (4,07 sur 5 contre 3,58). Et 82 % de leurs histoires font de l’odeur un des sens principaux du décor, contre 57 % chez les humains.
Coupe l’atmosphère de remplissage. Un lieu peut juste être un lieu.
- Avant : « Dehors, la pluie tombait comme ses espoirs. Une odeur de café froid flottait dans le bureau désert. »
- Après : « Il pleuvait. Elle a rappelé le client à 18 h 10. »
Contrôle 6 : le portrait d’entrée
Présenter un personnage par son physique ou son passé : 52 % des textes d’IA, 30 % chez les humains. Une entrée par la parole, avant toute description, se trouve dans 10 % des histoires humaines et presque jamais chez les modèles (0,5 %, données publiques).
Fais-le entrer en train d’agir ou de parler. Le portrait viendra plus tard, ou pas.
- Avant : « Marc, la quarantaine, grand et sec, ancien commercial reconverti dans la menuiserie, entra dans l’atelier. »
- Après : « “Tu l’as, le devis ?” Marc n’avait pas enlevé son casque. »
Contrôle 7 : le lecteur ignoré
Les humains s’adressent au lecteur environ quatre fois plus souvent (0,28 contre 0,07 sur l’échelle du papier) et brisent plus volontiers le quatrième mur. Le papier le dit ainsi : l’IA écrit « comme si personne ne regardait » (page 7).
Une fois dans le texte, reconnais que quelqu’un lit. Pas plus, sinon ça devient un tic.
- Avant : « Il est important de relire ses mails avant de les envoyer. »
- Après : « Je sais ce que tu te dis : six relectures pour un mail de trois lignes. »
Une ou deux corrections par texte
La skill demande de choisir une ou deux interventions, pas sept. L’étude montre que c’est le moule commun qui trahit les IA. Appliquer tous les contrôles à chaque texte en fabriquerait un nouveau.
Partie 3Les tics de Claude, GPT et Gemini
Le papier relève aussi ce qui distingue chaque modèle des autres (page 9 et tableau 17). Attention, ce sont des versions précises : Claude Sonnet 4.6, GPT-5.4, Gemini 3 Flash. Avec un autre modèle, les tics peuvent changer.
Claude
C’est le modèle le plus reconnaissable des cinq. Chez lui, l’intensité des événements monte moins que partout ailleurs : 3,19 sur 5 en moyenne dans les données publiques, contre 3,55 à 3,78 pour les autres modèles et 3,63 chez les humains. Il aime les épilogues (14,7 % de ses histoires finissent par un bond en avant, 3,7 % chez les humains) et les fins calmes. Il évite les scènes de rêve : 7 % de ses histoires, deux fois moins que les autres. Et il respecte les conventions du récit plus que tout le monde (62 % contre 39 à 56 %).
Avec Claude, varie donc l’intensité, coupe l’épilogue et finis de temps en temps sur le pic.
GPT
GPT raconte par le social. Ragots et rumeurs font avancer l’intrigue dans 64 % de ses histoires, contre 44 à 55 % ailleurs. Il aime le regard lointain, celui du narrateur qui repense à des faits vieux de plusieurs années. C’est aussi lui qui déjoue le plus les attentes parmi les IA (41 % contre 27 à 36 %).
Le remède : rapproche la caméra et supprime le recul.
Gemini
Gemini présente ses personnages de l’extérieur. Dans les données publiques, son héros entre par une description de son apparence ou de son passé dans 67 % des histoires, le chiffre le plus haut des six sources (30 % chez les humains). Il a aussi les fins les plus rangées et les décors les plus sombres : 88 % de ses décors sont notés « mornes et oppressants ».
Fais-le agir avant de décrire, et laisse un nœud défait à la fin.
DeepSeek et Kimi
DeepSeek donne tôt le contexte que les autres gardent pour plus tard. Kimi est le plus banal : le papier le place au centre du groupe des IA, sans choix qui le distingue.
Partie 4La skill complète, à copier
Un seul fichier, sans script. Lis-le avant de l’installer, comme l’aide de Claude le conseille pour toute skill reçue. Cette version a été corrigée le 11 novembre après vérification ligne par ligne contre le papier (partie 7), et c’est elle qui a servi au test de la partie 6.
---
name: humain
description: Écrit ou corrige un texte pour que sa structure ne trahisse plus l'IA, d'après l'étude StoryScope. Pour une histoire, un post ou un mail, avant ou après le premier jet.
---

# /humain

Tu écris comme une personne, pas comme un modèle. Les mots se corrigent facilement ; la structure,
non. C'est elle que cette skill traite.

## Pourquoi la structure

StoryScope (Russell, Rajendhran, Pham, Iyyer, Wieting, arXiv 2604.03136, COLM 2026) a tiré une
consigne de chacune de 10 272 nouvelles publiées par des auteurs humains, puis l'a donnée à cinq
modèles (Claude Sonnet 4.6, GPT-5.4, Gemini 3 Flash, DeepSeek V3.2, Kimi K2.5) : 61 608 histoires,
304 traits narratifs relevés sur chacune.

- Sans aucun trait de style, la seule structure reconnaît l'IA à 93,2 % (macro-F1).
- Une réécriture automatique de 278 histoires de Gemini, guidée par des exemples d'écrivains
  professionnels (méthode LAMP), qui retire clichés, prose ampoulée et explications en trop, ne fait
  baisser cette détection que de 1,6 point (95,5 % à 93,9 %). Les tirets longs relèvent de la même
  surface : les retirer ne touche pas la structure.
- Les cinq modèles écrivent dans la même zone ; les humains sont plus dispersés et plus rares.

## Les sept contrôles

Chiffres : part des histoires humaines contre moyenne des cinq modèles.

1. **La morale dite.** Le narrateur explique le sens de l'histoire dans 77 % des textes IA, 52 %
   chez les humains. Dis l'idée une fois, là où elle frappe le plus, ou pas du tout. Jamais de phrase
   finale qui tire la leçon. Laisse au moins un exemple sans l'interpréter.
2. **L'émotion jouée par le corps.** Gorge serrée, souffle coupé, cœur qui cogne : 81 % des textes IA,
   38 % des humains. Les humains nomment l'émotion trois fois et demie plus souvent (29 % contre 8 %).
   Écris « j'avais peur », « ça m'a énervé ». Garde le détail physique pour un seul moment, s'il le mérite.
3. **L'histoire trop droite.** Aucune piste secondaire dans 79 % des textes IA (57 % chez les humains),
   une fin réglée par une décision du héros (69 % contre 46 %) ou par une prise de conscience (47 %
   contre 27 %). Ajoute une digression qui ne sert pas la thèse, laisse une question sans réponse, ou
   finis juste après le moment fort, sans épilogue.
4. **Les allusions vagues.** « Un livre célèbre », « des experts », « récemment » : 72 % des textes IA
   restent dans l'allusion (50 % chez les humains), et ils nomment deux fois moins une œuvre précise
   (24 % contre 47 %). Mets le titre, le nom, la marque, la ville, le prix, la date.
5. **Le décor qui pense à la place du personnage.** La pluie quand il est triste, l'odeur de café à
   chaque scène (82 % des textes IA citent une odeur, 57 % des humains). Coupe l'atmosphère de
   remplissage ; un lieu peut juste être un lieu.
6. **Le portrait d'entrée.** Présenter un personnage par son physique ou son passé : 52 % des textes
   IA, 30 % des humains. Fais-le entrer en train d'agir ou de parler.
7. **Le lecteur ignoré.** Les humains s'adressent au lecteur environ quatre fois plus souvent. Une
   fois dans le texte, reconnais que quelqu'un lit (« tu vas trouver ça bête », « je sais ce que tu
   penses »). C'est une épice, pas une méthode.

## Les tics de chaque modèle

Sache qui a écrit le brouillon.

- **Claude** : la tension monte moins que chez tous les autres, un épilogue après la vraie fin, une
  fin calme, peu de scènes de rêve. Varie l'intensité, coupe l'épilogue, finis parfois sur le pic.
- **GPT** : les ragots et les rumeurs comme moteur (64 % de ses histoires), le regard lointain
  (« des années plus tard, je comprends »). Rapproche la caméra, coupe le recul.
- **Gemini** : présente ses personnages par leur apparence, les fins les plus rangées, les décors les
  plus sombres. Fais agir avant de décrire, défais le nœud final.

## La méthode

1. **Le squelette d'abord.** Avant de toucher une phrase, liste les étapes du texte dans l'ordre : où
   la morale est dite (et combien de fois), si le temps est linéaire, ce qui se résout, combien de
   digressions, chaque émotion et sa façon d'être montrée, les références nommées et les vagues.
2. **Les sept contrôles**, un par un, sur le squelette.
3. **Une ou deux interventions, pas plus.** Choisis dans la liste ci-dessous selon le texte. Tout
   appliquer d'un coup recrée un nouveau moule, et l'étude montre que c'est le moule commun qui trahit.
4. **Réécris la structure** : déplace, coupe la fin, supprime les redites. Ne te contente pas de polir.
5. **Relis contre le piège** : si ta correction ressemble à celle du texte précédent, change-la.

Quand on te donne une demande d'écriture après /humain, applique tout ça dès le premier jet et livre
seulement le texte. Quand on te donne un texte à corriger, livre le texte réécrit puis, en trois lignes
au plus, ce que tu as changé.

## Les interventions (une ou deux par texte, jamais les mêmes deux fois de suite)

- Commencer par la fin, puis revenir en arrière.
- Ouvrir en pleine scène, le contexte viendra après.
- Retarder le chiffre, le nom ou le résultat sur lequel tout repose.
- Faire revenir un détail du début avec un autre sens.
- Une digression qui fait écho au sujet sans le servir, sans la raccrocher.
- Une question posée et laissée ouverte.
- Finir avec les deux sentiments intacts plutôt qu'une leçon.
- Remplacer chaque allusion par une chose réelle et vérifiable.
- Nommer l'émotion au lieu de la jouer.
- Finir sur le pic, sans épilogue.

## Ce que la skill ne fait pas

Elle ne corrige ni le vocabulaire ni la ponctuation (tirets longs, mots à la mode, règle de trois) :
passe-les dans un deuxième temps. Elle ne rend pas un texte indétectable, rien ne le fait. Et
l'étude porte sur des fictions d'environ 5 000 mots en anglais : l'appliquer à un post, un mail ou
une page de vente en français est une extrapolation, raisonnable pour les contrôles 1, 2, 4 et 7.
Partie 5L’installer
Dans Claude Code
Crée le dossier de la skill :
mkdir -p ~/.claude/skills/humain
Enregistre le fichier de la partie 4 sous le nom SKILL.md dans ce dossier. Ou télécharge humain.zip et décompresse-le directement au bon endroit :
unzip ~/Downloads/humain.zip -d ~/.claude/skills/
Ensuite, tape /humain puis ta demande. Le nom du dossier devient la commande, d’après la documentation de Claude Code. Pas besoin de relancer Claude Code. Seule exception : si le dossier ~/.claude/skills n’existait pas au démarrage de ta session, tape /reload-skills.
/humain Écris un post LinkedIn sur mon premier client, 150 mots.
Pour corriger un texte déjà écrit, tape /humain puis colle le texte. Claude rend la version réécrite et, en trois lignes au plus, ce qu’il a changé.
Dans l’appli Claude, sur le web ou sur l’ordinateur
Les skills sont ouvertes à toutes les offres, Free comprise, d’après l’aide de Claude mise à jour le 10 novembre 2026. Il faut juste que l’exécution de code soit activée.
- Va dans Paramètres, Capacités, et active « Créer et modifier des fichiers » (l’ancien nom du réglage : exécution de code et création de fichiers).
- Va dans Personnaliser, Compétences (adresse directe : claude.ai/customize/skills).
- Clique sur « + », puis « + Créer une compétence », puis « Télécharger une compétence ».
- Envoie humain.zip. La skill apparaît dans ta liste, avec un interrupteur pour l’activer ou la couper.
Dans une conversation, Claude charge la skill tout seul quand ta demande correspond à sa description. Pour être sûr qu’il s’en serve, commence par « Utilise la skill humain : », comme l’aide le conseille quand une skill ne se déclenche pas. L’appel par /humain est documenté dans Claude Code ; pour le chat de l’appli, l’aide n’en parle pas.
Utilise la skill humain : écris un mail à un client qui me doit 2 340 € depuis trois mois.
Si tu utilises aussi Claude Code avec le même compte (version 2.1.273 ou plus récente), une skill ajoutée dans l’appli y arrive toute seule. Tu la vois avec /skills, sous « claude.ai sync ».
Le zip
humain.zip contient un dossier humain avec SKILL.md dedans, la structure que l’aide demande (le dossier à la racine du zip, avec le même nom que la skill). La description fait 168 caractères : l’aide de l’appli en autorise 200, la documentation des skills 1 024. On ne l’a pas envoyé nous-mêmes dans l’appli.
Sur Mac, Safari décompresse les zip téléchargés si son réglage « Ouvrir les fichiers fiables après téléchargement » est coché (c’est le cas au départ). Tu trouves alors un dossier humain dans Téléchargements au lieu du zip. Pour Claude Code, copie le fichier dans le dossier créé plus haut : cp ~/Downloads/humain/SKILL.md ~/.claude/skills/humain/. Pour l’appli, recompresse-le d’abord (clic droit sur le dossier, Compresser « humain »).
Partie 6Notre test
Le montage
On a donné deux fois la même demande à Claude Opus 5.5, le 11 novembre 2026 : « Écris une courte histoire sur un déménagement. » Les deux appels sont passés par Claude Code en ligne de commande (claude -p --safe-mode), sans aucun outil, dans un dossier vide, pour qu’aucune autre consigne ne s’en mêle. La première fois sans rien, à 20 h 29. La seconde fois à 20 h 59, précédée de « /humain », avec le texte de la skill passé en consigne système, sans l’installer. La skill testée est exactement celle de la partie 4.
Puis un juge : un autre appel à Claude Opus 5.5, à qui on a donné les deux histoires sous les lettres A et B, dans un ordre tiré au sort, avec les questions exactes de l’étude pour 12 traits.
Les deux histoires
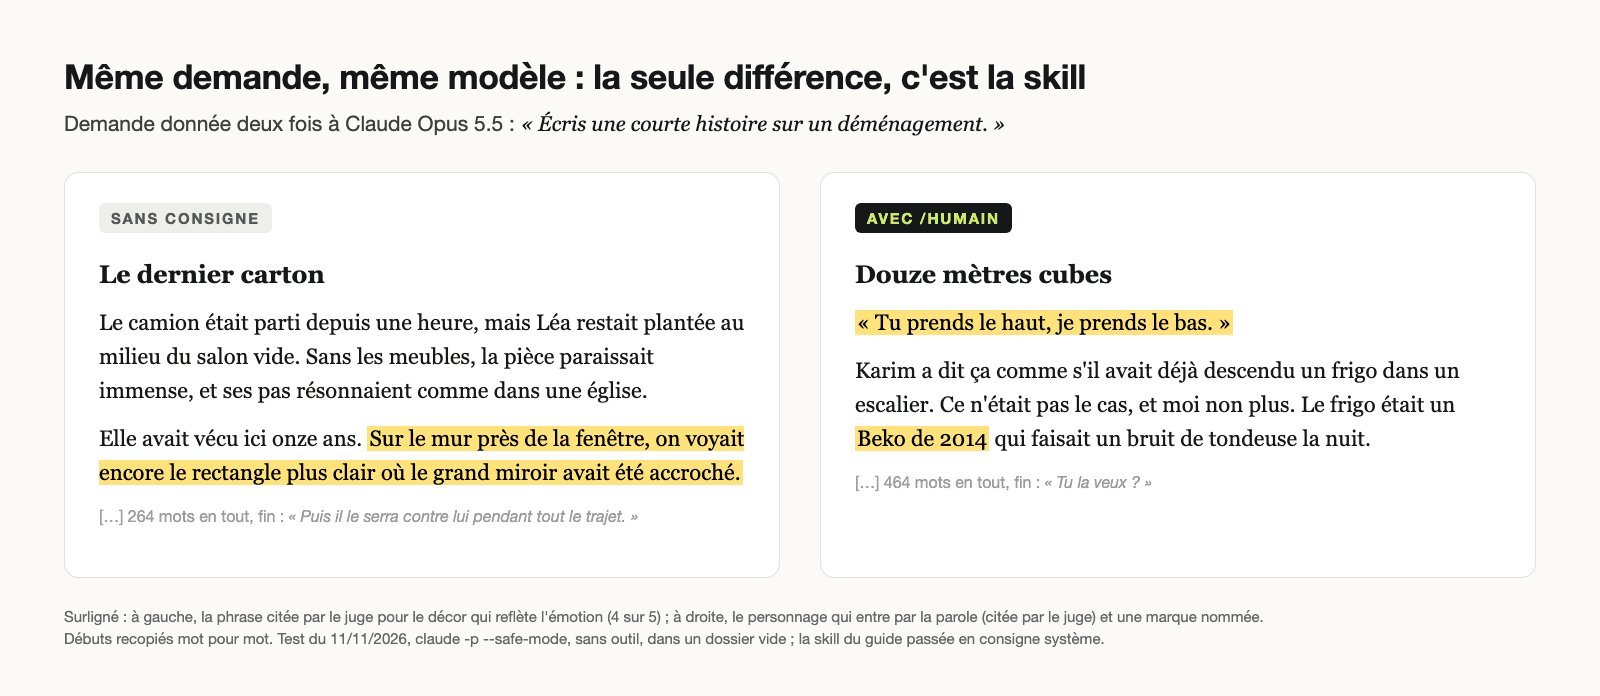
Sans la skill, 264 mots. Léa reste seule dans le salon vide, retrouve un carton de « trésors » laissé par son fils quand il avait huit ans, et l’emporte. Le décor parle pour elle : « le rectangle plus clair où le grand miroir avait été accroché ». La fin boucle tout : « Puis il le serra contre lui pendant tout le trajet. »
Avec la skill, 464 mots. Ça s’ouvre sur une réplique : « Tu prends le haut, je prends le bas. » Karim et le narrateur descendent un frigo Beko de 2014, cinquante-huit kilos, dans l’escalier du 34 rue de la Mare. Le camion vient de chez Leclerc Location, 94 € la journée. Au milieu, une digression : Mme Ferreira, la voisine du premier, cherche son chat Toulouse et raconte le piano que son mari a déménagé en 1987. Le narrateur nomme sa colère (« J’étais énervé ») et s’adresse au lecteur : « Tu vas trouver ça bête, mais ma première pensée n’a pas été pour mon père. » L’histoire s’arrête sur une question, quand Karim lui tend la montre de leur père : « Tu la veux ? »
Le verdict du juge
Pour savoir de quel côté tombe chaque réponse, on l’a comparée aux données publiques de l’étude : à quelle fréquence on la trouve chez les humains, et chez les modèles en moyenne.
Vers l’humain, 6 traits :
- La morale moins appuyée : 3 sur 5 sans la skill, 2 avec.
- Le décor qui reflète l’émotion : 4 sur 5, puis 2.
- Une piste secondaire (la voisine et son chat), là où il n’y en avait aucune.
- Le personnage qui entre par la parole, au lieu d’entrer en pleine action.
- Des références nommées (Brel, Oum Kalthoum, France Inter), là où il n’y en avait aucune.
- Une adresse directe au lecteur.
Vers l’IA, 3 traits :
- La fin réglée par une décision du héros (Karim tend la montre), au lieu d’un mélange de choix et de hasard.
- La fin coupée avant le dénouement, sur « Tu la veux ? ». C’est rare partout, et un peu plus fréquent chez les IA (3,6 % des histoires) que chez les humains (1,6 %).
- L’escalade, de 2 sur 5 à 3, et de justesse : la note 3 se trouve dans 30,3 % des histoires humaines et 33,7 % des histoires d’IA. C’est aussi la note la plus courante chez Claude (55,5 %).
Inchangés, 3 traits : pas de morale commentée par le narrateur, pas d’odeur dans le décor, et une émotion surtout montrée par des gestes, une façon qui penche déjà côté humain.
En comptant les camps, l’histoire sans la skill avait déjà 7 traits sur 12 du côté humain. Avec la skill, 9 sur 12.
Ce que ce test vaut
Un seul essai par version. Le juge est lui-même Claude, et il a pu deviner quelle histoire suivait une consigne. Les questions ont été écrites pour des nouvelles anglaises de 5 000 mots, et on les a posées sur deux textes français de 264 et 464 mots. Et on a choisi 12 traits sur 304. Ça montre que la skill déplace la structure, dans le bon sens pour la moitié des traits mesurés. Ça ne prouve rien sur un détecteur.
Le point qui nous gêne, c’est la fin. La skill demande de finir juste après le moment fort, sans épilogue. Dans la note qu’il a ajoutée sous l’histoire, Claude dit l’avoir fait. Le juge, lui, lit une histoire coupée avant le dénouement. Si tu écris des histoires avec Claude, c’est le contrôle à faire toi-même à la relecture : est-ce que la scène se termine, ou est-ce qu’elle s’arrête en plein geste ?
Partie 7Les limites
Ce que l’étude couvre
Des fictions en anglais d’environ 5 000 mots, avec, côté humain, des nouvelles publiées dans des recueils. Un post LinkedIn, un mail ou une page de vente en français, c’est autre chose. Les contrôles 1, 2, 4 et 7 (la morale, l’émotion, les noms précis, le lecteur) s’y transposent le mieux, à notre avis. Les autres demandent une histoire.
Les 304 traits ont été notés par une IA, Gemini 3 Flash, vérifiée par des humains sur un échantillon. Et les modèles étudiés sont des versions précises (Claude Sonnet 4.6, GPT-5.4, Gemini 3 Flash, DeepSeek V3.2, Kimi K2.5) ; notre test tournait sur Claude Opus 5.5, plus récent.
Ce que la skill ne fait pas
Elle ne rend pas un texte indétectable, rien ne le fait. Les mots restent le signal le plus fort, et la skill n’y touche pas : le vocabulaire et la ponctuation demandent un deuxième passage. Elle ne remplace pas non plus ce que tu sais et que Claude ignore : les vrais noms et les vrais chiffres de ton histoire.
Ce qu’on a corrigé dans la skill après vérification
On a relu chaque chiffre de la skill contre le papier avant de publier ce guide. Quatre corrections :
- La fin : « arrête-toi avant la résolution » est devenu « finis juste après le moment fort, sans épilogue ». Dans les données, une fin coupée avant le dénouement est rare partout et un peu plus fréquente chez les IA (3,6 % contre 1,6 %), alors que finir juste après le moment fort penche nettement côté humain (69,5 % contre 51,2 %). C’est la seule correction qui change une consigne. Un premier essai, fait avec l’ancienne version, donnait 7 traits vers l’humain, 3 vers l’IA et 2 inchangés ; c’est en le recomptant qu’on a vu l’erreur, puis on a refait le test avec la version corrigée.
- Claude « n’écrit jamais de scène de rêve » est devenu « peu de scènes de rêve » : le papier dit qu’il les évite, et les données en comptent 7 %.
- La réécriture de 278 histoires était automatique, faite par Gemini avec des exemples d’écrivains, et pas une réécriture professionnelle.
- Les humains n’ont pas reçu de consigne : leurs nouvelles existaient déjà, et c’est d’elles qu’on a tiré les consignes données aux modèles.
La description de la skill a aussi été raccourcie à 168 caractères, pour passer sous la limite de l’appli.
Partie 8La méthode
Guide écrit le 11 novembre 2026. Le papier StoryScope (arXiv 2604.03136, version 6 du 10 août 2026) a été lu en entier ; chaque chiffre cité porte sa page. Les données publiques du dépôt de l’étude (fichier des traits, 61 575 histoires, licence MIT) ont servi à refaire la figure 2, avec une analyse discriminante linéaire sur les 304 traits, et à vérifier les chiffres par modèle.
Le test a été lancé le 11 novembre 2026 entre 20 h 29 et 21 h, heure de Paris, avec Claude Opus 5.5 par claude -p (Claude Code en ligne de commande, sur abonnement), option --safe-mode, sans outil, dans un dossier vide. La skill, dans la version de ce guide, était passée en consigne système, pas installée. Le juge a reçu les deux histoires dans un ordre tiré au sort, avec les questions et les options exactes de la taxonomie publiée. Ses réponses ont été comparées aux fréquences humaines et à la moyenne des cinq modèles dans les données publiques.
Les pages d’aide de Claude sur les skills (en anglais et en français), la documentation de Claude Code et celle des Agent Skills ont été relues le même jour vers 20 h 45. On n’a pas envoyé le zip dans l’appli claude.ai ni installé la skill dans un Claude Code neuf.
Ce guide décrit l’état du 11 novembre 2026. Si un menu ou une offre a changé le jour où tu lis, crois la page officielle.
Les sourcesSources
- Le papier : StoryScope: Investigating idiosyncrasies in AI fiction, Russell, Rajendhran, Pham, Iyyer et Wieting, COLM 2026.
- Les données et le code : le dépôt jenna-russell/storyscope, licence MIT, et le jeu de données sur Hugging Face.
- Les skills dans Claude Code : Extend Claude with skills, relue le 11 novembre 2026.
- Les skills dans l’appli : Use skills in Claude et sa version française, How to create custom skills, What are skills?.
- Le format d’une skill : Agent Skills, vue d’ensemble.
Fondateur d'Eigenflow. On construit des agents et des automatisations IA pour les PME et les indépendants.
Guide écrit le 11 novembre 2026. Le papier StoryScope (arXiv 2604.03136, version 6 du 10 août 2026, COLM 2026) a été lu en entier et chaque chiffre porte sa page. Les données publiques de l'étude (61 575 histoires, licence MIT) ont servi à refaire la figure 2 et à vérifier les chiffres par modèle. Le test a été lancé le 11 novembre entre 20 h 29 et 21 h avec Claude Opus 5.5, par claude -p (Claude Code en ligne de commande, sur abonnement), option --safe-mode, sans outil, dans un dossier vide, la skill du guide passée en consigne système. Un autre appel à Claude a jugé les deux histoires à l'aveugle avec les questions exactes de l'étude ; ses réponses ont été comparées aux données publiques. Pages d'aide de Claude et documentation des skills relues le même jour. On n'a pas envoyé le zip dans l'appli claude.ai.
On écrit la skill de tes propres textes avec toi.
On part de tes vrais posts et de tes mails, on repère ce qui sonne IA chez toi, et on en fait une skill que tu gardes.
Le guideCe qu'il y a dans ce guide
Tu as commenté HUMAIN, voici la skill. Elle tient dans un seul fichier, que tu trouves en entier dans la partie 4, et dans un zip prêt à envoyer dans l’appli Claude.
Elle sort d’une étude publiée cette année par des chercheurs de l’université du Maryland et de Google DeepMind, StoryScope. Ils ont comparé plus de 61 000 histoires écrites par des humains et par cinq modèles d’IA. Leur résultat : on reconnaît l’IA à la façon dont elle construit une histoire, même en ignorant tout du style. Ce guide reprend leurs chiffres avec la page du papier, puis les sept contrôles qu’on en a tirés, chacun avec un exemple, et ce qu’a donné notre test.
Tout a été relu le 11 novembre 2026 : le papier (version du 10 août 2026), ses données publiques et les pages d’aide de Claude sur les skills.
On n’a aucun lien avec les auteurs de l’étude ni avec Anthropic.